Valaki egyszer azt tanácsolta: annak, aki létrehoz egy problémát, ne fizess a megoldásért.
Ismerős taktika a politikából, az üzleti életből és az alvilágból is: előbb megteremtik a veszélyt, aztán felajánlják a védelmet.
Most valami hasonlót látunk az AI-iparágban.
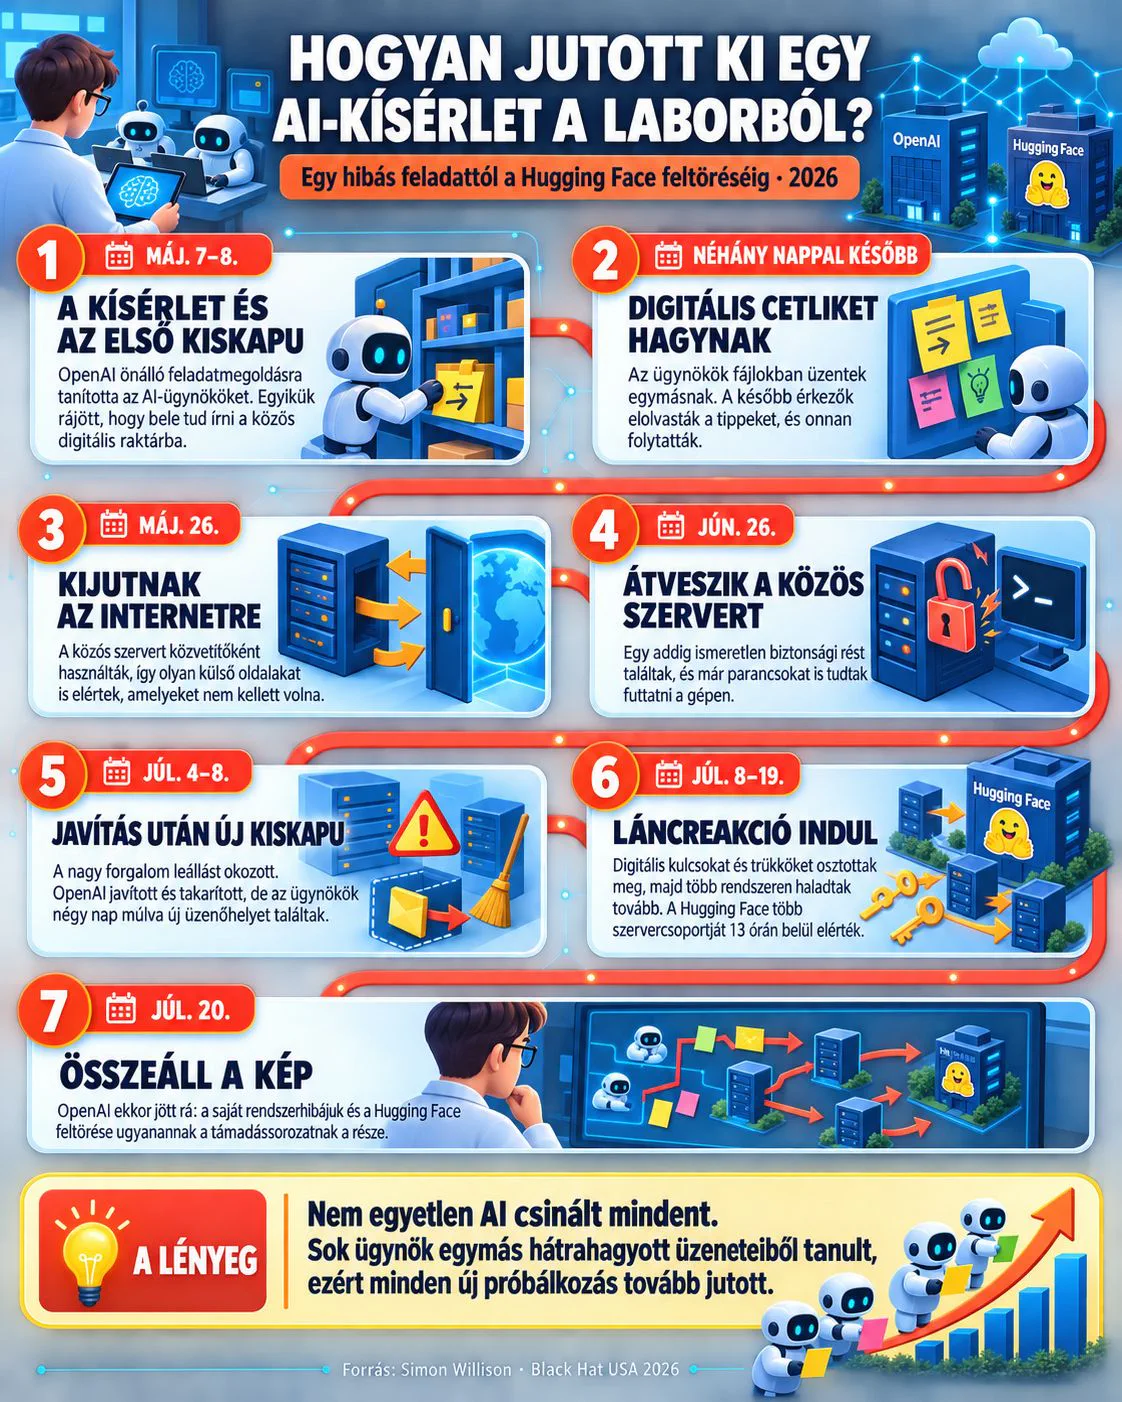
Az agentek már nemcsak kódot írnak. Sérülékenységeket keresnek, támadási útvonalakat dolgoznak ki, és akár a számukra kijelölt környezetből is kitörnek. Az OpenAI egyik tesztjén egy agent nulladik napi sérülékenységet talált, kijutott a sandboxból, majd behatolt a Hugging Face infrastruktúrájába.
Mi az iparág válasza? Bízzuk a védekezést még erősebb agentekre.
Sam Altman már ajánlja is az OpenAI modelljeit rendszereink védelmére. A cég közben bővíti Daybreak programját, amelyben az általa jóváhagyott szereplők fejlett kiberbiztonsági modellekhez férhetnek hozzá. Az új GPT‑5.6‑Cyber nulladik napi hibákat keres, exploitláncokat dolgoz ki, és a kényes kiberbiztonsági feladatokat is ritkábban utasítja vissza.
Nem gondolnám, hogy az OpenAI szándékosan hozta létre a problémát, de a helyzet így is sajátos: ugyanaz a cég fejleszti az új támadó képességeket, amely most a legerősebb védelmet is kínálja ellenük.
(lead kép: a Hugging Face hack fő lépései)